- OOM 강제 종료
- 하루 약 6회
- 0회 (배포 후 62시간)
- 메모리 증가 속도 (p95)
- 시간당 9~10%
- 시간당 약 0.1% (셋째 날, 거의 멈춤)
- 고유 경로 1개당 누적 (로컬 재현)
- 약 540KB
- 0
- 없는 채널 주소 응답
- 200
- 404
문제
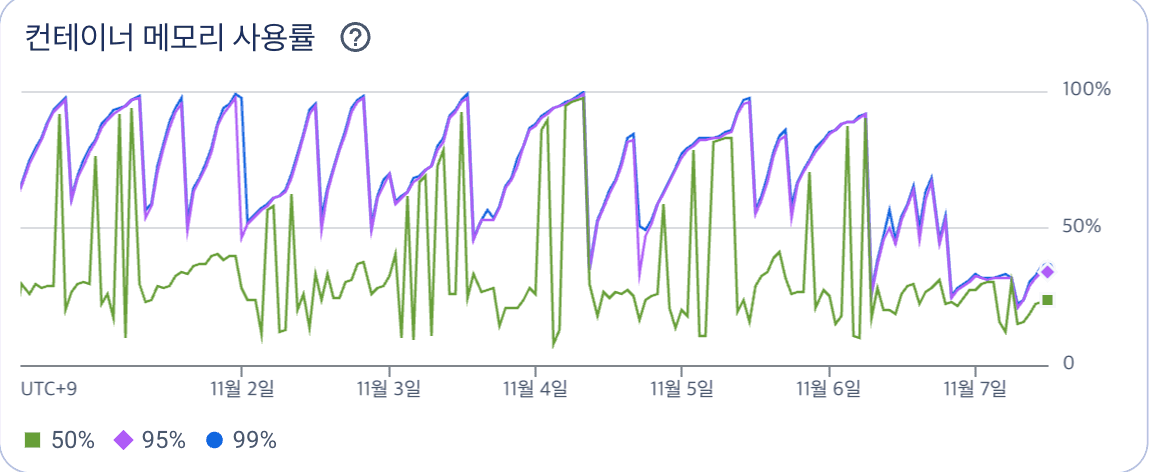
운영 웹 서버(Next.js 14 Pages Router, Cloud Run 인스턴스당 메모리 2GiB)가 Memory limit of 2048 MiB exceeded로 하루 약 6번 강제 종료되고 있었습니다. 7일 동안 38건이었습니다. 종료되는 순간 처리 중이던 요청은 실패했고, 서버에 쌓여 있던 캐시도 통째로 사라졌습니다.
코드에서 운영 지표로
처음 받은 질문은 "메인 페이지나 서비스 전반에 메모리 누수를 일으키는 코드가 있는지 봐 달라"였습니다. 그래서 정적 감사부터 했습니다. 클라이언트(메인 페이지, _app 전역)와 서버(getServerSideProps, API 라우트, middleware)를 나눠 리스너·타이머·Observer·Firebase 구독·Swiper·모듈 레벨 캐시를 전부 확인했습니다.
정리 함수가 빠진 클라이언트 누수는 없었습니다. 대신 서버 쪽에서 후보 둘이 나왔습니다. 메인 페이지 SSR 캐시의 키가 끝없이 늘어날 수 있다는 점, 그리고 ISR 결과가 디스크에 기록된다는 점이었습니다. 설치된 Next 14.2.26 소스에서 증분 캐시 동작을 확인해 보니, isrFlushToDisk는 기본값이 true이고 디스크에 쓴 파일을 지우는 로직은 없었습니다.
여기까지는 "그럴 수 있다"였습니다. 실제로 일어나고 있는지는 운영 지표를 봐야 했습니다. Cloud Run 메모리 그래프는 2주 내내 톱니 모양이었고, Cloud Logging에서 메모리 한도 초과 종료가 7일간 38건 나왔습니다. 문제는 실제로 있었습니다.
0이라고 원인이 아닌 건 아니다
원인을 확인하려고 Cloud Run의 "인메모리 파일 시스템 사용량" 지표를 열었습니다. 이름만 보면 바로 답을 보여 줄 지표인데, 2주 내내 거의 0이었습니다.
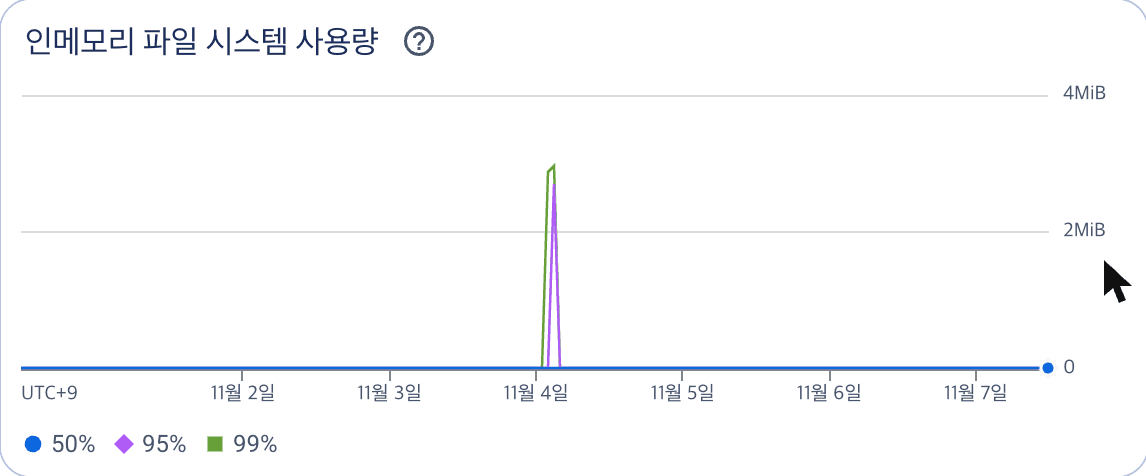
이 지표만 믿었다면 디스크 가설을 버렸을 겁니다. 하지만 이 지표가 무엇을 재는지는 확인하지 못한 상태였고, Cloud Run 문서는 컨테이너가 쓴 파일이 인스턴스 메모리 한도를 함께 쓴다고 적고 있었습니다. 지표와 문서가 어긋나면 어느 한쪽으로 결론을 내리지 않고 직접 재현해 보기로 했습니다.
재현으로 원인과 비원인을 가르기
운영 HTML과 /_next/data JSON을 받아 크기를 재 보니 경로 하나가 약 550KB였습니다. HTML이 약 300KB, JSON이 약 270KB였고, JSON의 약 90%(255KB)는 next-translate가 모든 페이지 props에 넣는 번역 namespace였습니다. HTML의 __NEXT_DATA__에도 같은 내용이 한 번 더 들어갑니다.
그다음 standalone 빌드를 로컬에 띄우고, 고유한 채널 주소 300개씩을 요청하면서 디스크 사용량과 프로세스 메모리(RSS)를 쟀습니다.
| 상황 | 응답 | 디스크 | 파일 수 | 비고 |
|---|---|---|---|---|
| 고유 주소 300개 (3회 반복) | 모두 200 | 회당 +162MB | 회당 +900 | 경로당 약 540KB, 선형 증가 |
| 이미 요청한 300개 재요청 | 모두 200 | +0 | +0 | 같은 경로는 덮어쓰기 |
| 요청 없이 둔 뒤 RSS | 약 870MB → 약 300MB로 회수 | JS 힙 누수는 아님 |
세 숫자가 원인과 비원인을 동시에 갈랐습니다. 새 경로마다 파일이 선형으로 쌓이고, 같은 경로는 늘지 않으며, 힙은 GC가 제대로 회수합니다. 처음 질문이었던 "코드의 메모리 누수"는 없었고, 원인은 파일 누적이었습니다.
합리적인 기본값 여러 개가 맞물린 결과
원인은 하나의 버그가 아니었습니다. 각각은 합리적인 동작 일곱 개가 이어져 있었습니다.
봇의 고유 채널 주소 요청
  ↓
fallback: 'blocking' 렌더
  ↓
채널 API 응답 (200이든 404든)
  ↓
ISR 엔트리 저장
  ├─ 메모리 LRU: 50MB 상한
  └─ .next/server/pages 파일 기록: 상한·삭제 없음
       ↓
     Cloud Run 인메모리 파일시스템
       ↓
     컨테이너 메모리 2GiB 도달
       ↓
     OOM 강제 종료: 요청 실패 + 캐시 초기화
- 봇이 서로 다른 채널 주소를 계속 요청합니다. 로드밸런서 로그 50초 구간에 여러 크롤러가 서로 다른
/channel/@User-…주소를 20개 넘게 요청했습니다(초당 약 0.4건). - 채널 페이지는 처음 오는 주소를 그 자리에서 렌더해 저장합니다.
getStaticPaths가paths: [],fallback: 'blocking'이라 빌드 때는 아무것도 만들지 않고, 요청이 올 때마다 새 ISR 엔트리를 만듭니다. - 없는 채널도 저장 대상이 됩니다. 채널 API가 404를 줘도 에러 props를 반환했기 때문에, 가짜 핸들마다 200 페이지가 만들어져 캐시에 들어갔습니다.
- Next는 ISR 결과를 메모리 LRU와 디스크 두 곳에 씁니다. 메모리 LRU는 50MB 상한이 있지만, 디스크 기록에는 상한도 삭제도 없습니다. 경로마다
.html,.json,.meta세 파일이 생깁니다. - 페이지 하나가 큽니다. 위에서 잰 것처럼 경로당 약 540KB입니다.
- Cloud Run의 파일시스템은 메모리입니다. Next 입장에서는 디스크에 썼지만 실제로는 인스턴스의 RAM이 줄어듭니다.
- 2GiB에 닿으면 인스턴스가 강제 종료됩니다. 여유분 약 1.2GB를 540KB로 나누면 약 2,200개 경로입니다. 메모리 그래프가 톱니 모양이 된 이유입니다.
수정
// next.config.mjs
experimental: {
  isrFlushToDisk: false, // ISR 결과는 상한 50MB의 메모리 LRU에만 둔다
},
- ISR 디스크 기록 끄기: 끝없이 늘던 경로를 상한이 있는 메모리 LRU로 바꿨습니다. LRU에서 밀려난 페이지는 다시 렌더합니다. 빌드 때 만든 정적 페이지를 읽는 데에는 영향이 없습니다.
- 없는 채널은 404: 채널 API가 404이면서 메시지가 백엔드의 "채널 없음" 문구일 때만
{ notFound: true, revalidate: 60 }을 돌려줍니다.revalidate를 붙여, 나중에 생긴 채널이 영영 404로 남지 않게 했습니다. 기관 격리 403, 5xx, 네트워크 에러, 라우트 미스 404는 기존처럼 에러 화면과 10초 재시도로 둡니다. - 메인 페이지 캐시 키 고정: 메인 페이지 SSR 캐시 키로
locale쿠키 값이 그대로 들어가고 있었습니다. 쿠키는en과ko만 허용하고 나머지는ko로 바꿔, 캐시 항목을 최대 8개로 고정했습니다. - 회귀 테스트: 수정마다 기존 구현에서 실패하는 테스트를 먼저 확인한 뒤 통과시켰습니다. 원인, 설정, "Cloud Run 파일시스템 지표로 원인을 배제하지 말 것"이라는 함정, 404 판정 규칙은 팀 문서로 남겼습니다.
수정한 뒤에는 별도로 회귀·안전 검토를 받아 코드와 운영 API를 다시 대조했습니다. 여기서 처음 구현의 문제가 하나 나왔습니다. 처음에는 "채널 API가 404면 notFound"로만 판정했는데, 백엔드 배포 중에 생기는 라우트 미스도 404라서, 멀쩡한 채널이 5분간 404로 굳을 수 있었습니다. 운영·개발 API가 없는 채널에는 {"status":404,"message":"Not found channel"}을, 라우트 미스에는 "Cannot GET …"을 준다는 걸 직접 확인하고 판정을 문구까지 좁혔습니다. 백엔드 문구가 바뀌면 404 처리만 꺼지는, 안전한 방향으로 실패합니다.
하지 않은 것
- 공유 캐시를 들이지 않았습니다. Redis 같은 공유 캐시(
cacheHandler)나 GCS 볼륨 마운트도 대안이었지만 둘 다 인프라가 늘어납니다. 원래도 디스크는 인스턴스마다 따로라 인스턴스 사이의 캐시 공유는 없었으므로, 디스크 기록을 꺼도 잃는 공유는 없었습니다. - 메모리 LRU 상한(50MB)을 올리지 않았습니다. 검토에서 256MB로 올리자는 제안이 나왔습니다. 하지만 운영 힙 한도는 Node 24가 컨테이너에 맞춰 자동으로 정하고(팀 규칙상 직접 지정하지 않습니다), Next의 LRU는 엔트리 크기를 문자 수로 세는데 JS 문자열은 UTF-16이라 한글이 많으면 실제 메모리가 계산값의 최대 약 2배가 됩니다. 근거 없이 올리면 이번에는 힙 OOM을 만들 수 있어서, 배포 후 캐시 적중률을 보고 조정하기로 했습니다.
- 언어 쿠키는 캐시가 아니라 입력에서 막았습니다. 캐시에 크기 상한을 거는 방법도 있었지만, 그러면 쓰레기 키가 캐시에서 밀려나며 매번 외부 API를 부릅니다. 문제를 옮길 뿐이라 입력 지점에서 허용 값만 통과시켰습니다.
결과: 같은 조건끼리 비교하기
배포 후 62시간 동안 OOM 강제 종료는 0건이었습니다. 첫날 밤 컨테이너 메모리 p95는 4시간 동안 31% 근처에서 멈췄고, 16시간 뒤 33.8%였습니다. 배포 전 기울기(시간당 약 9%)였다면 그 사이 한도에 닿았을 시간입니다.
배포 후 관측이 밤 시간대에 걸쳐 있어서, 트래픽이 적어서 느리게 오른 것일 수도 있었습니다. 그래서 두 가지로 이 가능성을 배제했습니다. 배포 전에는 트래픽이 더 적은 새벽에도 시간당 약 8%씩 올랐고, 같은 7일 동안 인스턴스 수와 CPU는 배포 전후가 비슷하고 메모리 모양만 바뀌었습니다. OOM이 더 잦았던 다른 리전에서도 배포 전 평일과 배포 당일의 같은 24시간 창을 나란히 놓았습니다.
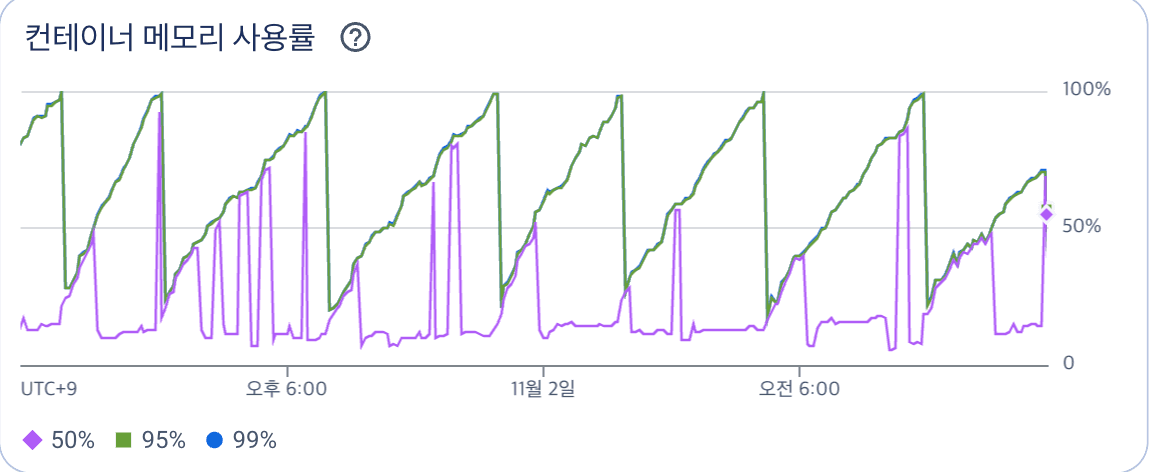
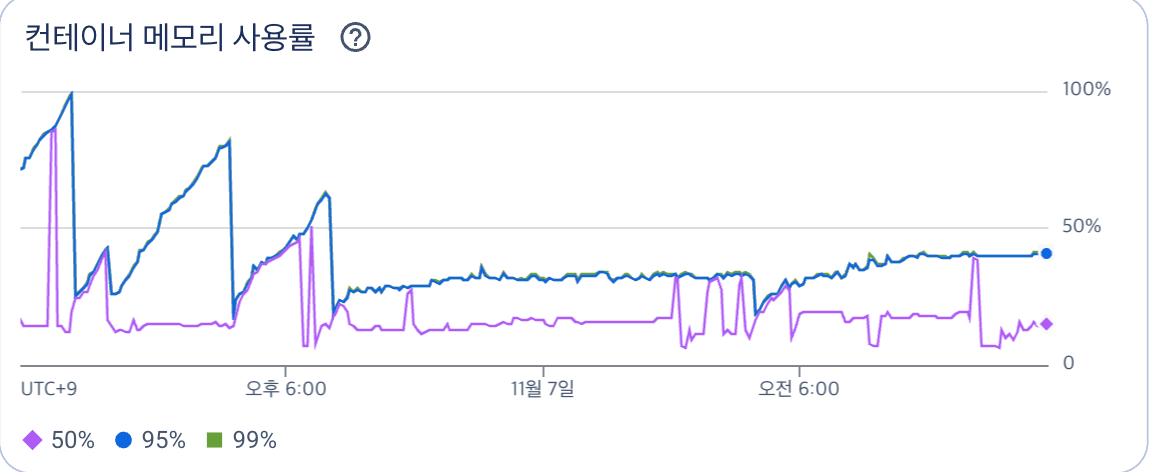
다만 둘째 날에는 증가가 완전히 멈추지 않았습니다. 강제 종료는 한 번도 없었지만, 두 리전의 p95가 하루 사이 각각 약 12%p와 5%p 올랐습니다. 시간당 0.2~0.5%로, 배포 전보다 20분의 1 이하로 느려졌지만 0은 아니었습니다.
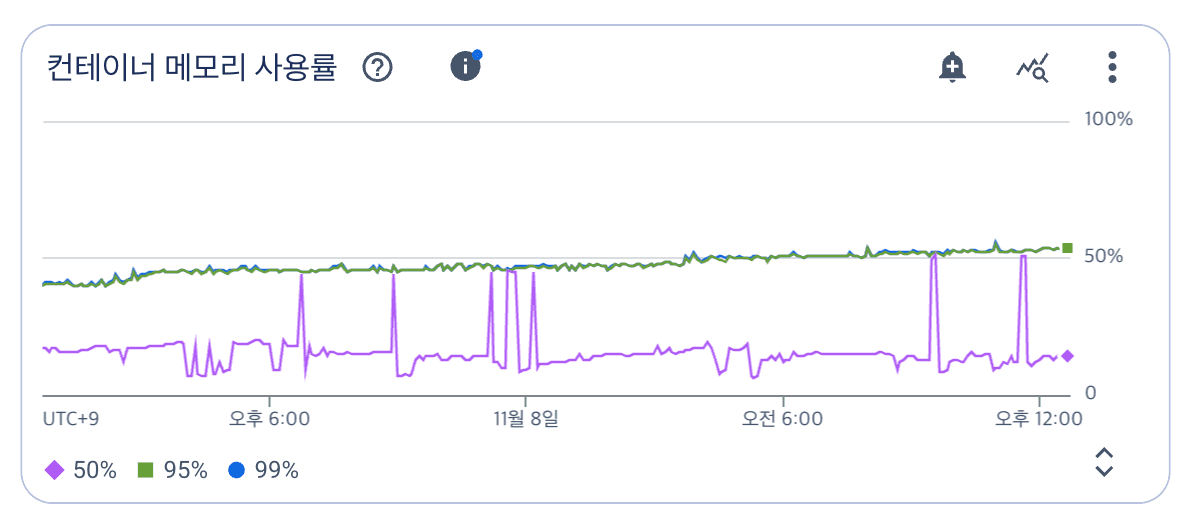
셋째 날에는 증가가 거의 멈췄습니다. 아래는 콘솔 그래프에서 같은 시각의 p95를 리전별로 읽은 값입니다.
| 시각 (KST) | 리전 A (OOM이 더 잦았던 곳) | 리전 B |
|---|---|---|
| 11/6 21시 (배포 직후) | 28.5% | 28.8% |
| 11/7 16시 | 44.8% | 36.3% |
| 11/8 10시 | 51.9% | 40.7% |
| 11/8 23시 | 55.8% | 44.8% |
| 11/9 09시 | 57.0% | 44.6% |
오르는 폭이 구간마다 줄어듭니다. 직선이 아니라 어떤 상한에 다가가는 곡선이고, 셋째 날 아침에는 시간당 약 0.1%였습니다.
대가도 있습니다. 메모리 캐시는 인스턴스당 페이지 약 90개(550KB 기준)를 담는 크기라, 밀려난 롱테일 페이지는 다시 렌더합니다. 캐시 적중 시 약 0.13초이던 응답이 MISS일 때는 약 0.5초입니다. 이전에는 디스크의 옛 페이지가 백엔드 장애를 가려 줬지만, 이제 캐시에 없는 페이지는 장애 중에 에러 화면이 보일 수 있습니다. 채널·이벤트·게시글·오픈플레이·정적·메인 페이지 응답은 모두 200으로 이상이 없었습니다.
에러 트래커로는 보이지 않던 것
Sentry 이벤트는 배포 전후로 눈에 띄게 줄지 않았고, 줄 것으로 기대할 근거도 약했습니다. OOM으로 프로세스가 강제 종료되면 서버의 Sentry SDK는 보고할 틈이 없습니다. 브라우저의 API 호출은 Next 서버가 아니라 백엔드로 직접 가므로, Next 인스턴스가 죽어도 그 흔적이 Sentry에 남지 않습니다. 실제로 OOM이 세 번 난 밤에도 Sentry의 5xx 이벤트는 1건이었습니다.
그래서 이번 효과를 판단하는 지표는 Sentry가 아니라 Cloud Logging의 OOM 로그와 Cloud Run 메모리 그래프였습니다. 반대로 배포 후 늘어난 5xx 57건은 Sentry 덕분에 배포 다음 날 오전의 백엔드 DB 장애로 바로 분리할 수 있었습니다. 프로세스가 통째로 죽는 장애와 애플리케이션 예외는 보이는 곳이 달랐습니다.
남은 과제
- 페이지당 번역 데이터: 페이지 JSON의 90%가 번역 namespace입니다. 이걸 줄이면 캐시 한 칸이 가벼워져 같은 50MB에 더 많은 페이지가 들어가고, 전송량도 줄어듭니다.
- 이미지 최적화 504: 한 페이지의
/_next/image요청 수십 개가 동시에 20초 타임아웃되는 일이 주기적으로 있습니다. 이번 건과 별개의 기존 문제입니다. - 남은 완만한 증가: 둘째 날 하루 약 12%p 오르던 증가가 셋째 날 거의 멈췄습니다(리전 A 57%, 리전 B 45%). 하루 더 60% 아래에 머물면 해결로 확정합니다. 다시 오르기 시작하면 Next 내부의 재검증 시각 Map(고유 경로마다 항목이 영구히 남지만 항목당 수백 바이트), OpenTelemetry의
SimpleSpanProcessor(span을 하나씩 즉시 전송하고 대기열 상한이 없음), V8 힙을 후보로 두고, 인스턴스별 힙 추이 로그나 로컬 장시간 재현으로 좁힐 계획입니다.